Voor je een measure schrijft: klopt je model?
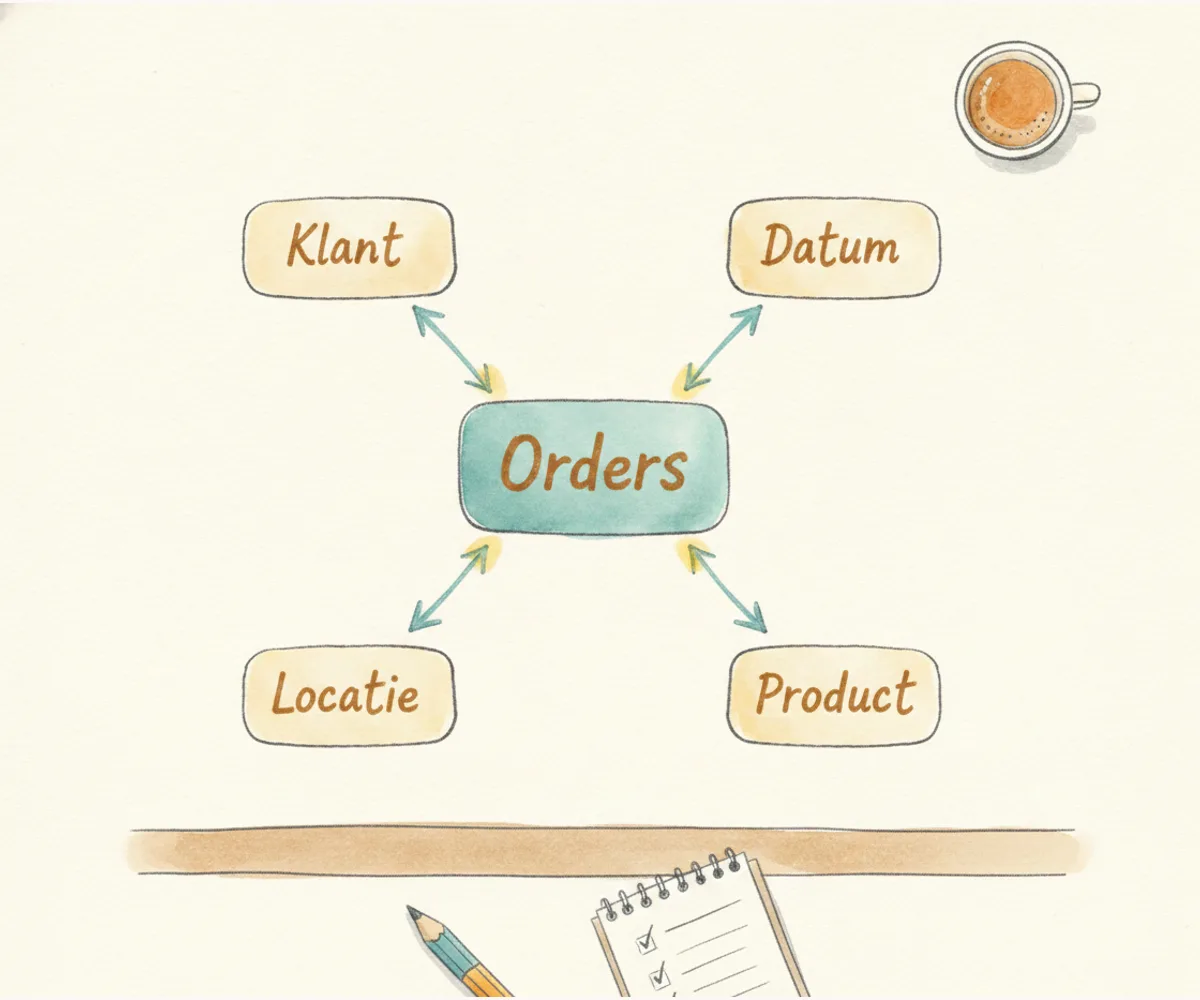
Als je measure gek doet, is het bijna nooit je DAX.
Dat klinkt misschien als een omweg, maar het is een echte diagnostische stap: voordat je in de CALCULATE-documentatie duikt of je formule voor de derde keer herschrijft, loont het om drie minuten in je modelweergave door te brengen. De meeste measure-problemen die ik tegenkom in trainingen zijn modelproblemen in vermomming. En een modelprobleem los je niet op door de measure slimmer te maken; de fix zit altijd een stap eerder.
Dit artikel is de checklist die je meeneemt naar de filterfuncties. Niet als definitieve gids voor datamodellering, maar als drie concrete diagnose-vragen die je stelt voordat je aan CALCULATE begint.
Waarom het model eerder aan de beurt is
Een measure is de uitkomst van een expressie op de tabel die overblijft nadat de filtercontext is toegepast. Die filters komen uit de visual op je canvas, uit de slicers die de gebruiker gebruikt, en uit de kolommen waarop de pagina staat te filteren. Ze reizen via de relaties in je model naar de feittabel. Als die weg niet klopt, klopt de uitkomst ook niet, hoeveel DAX-kennis je daarna ook in de measure stopt.
De filtercontext is een modeleigenschap: DAX werkt met wat het model hem geeft. Dat maakt het model een stap eerder verantwoordelijk dan de measure zelf.
Heeft mijn model de vorm van een ster?
De feittabel staat in het midden, de dimensies staan eromheen (Date, Product, Customer, Region), en de relaties lopen one-to-many van dimensie naar feit. Dat is het stermodel, en het is de benadering die Microsoft aanbeveelt voor Power BI: filters propageren voorspelbaar, de filtercontext blijft eenduidig, en een measure die in de ene context goed werkt doet dat ook in de andere.
Wat ik in trainingen zie: alles in één brede platte tabel gestopt, “want dan staat het er tenminste in”. Dat werkt tot je begint te filteren. Zodra je een slicer op klant zet, staan klantnaam en productnaam in dezelfde rij, en de filtercontext gedraagt zich op een manier die niet goed te voorspellen is. Een totaal in een subgroep wijkt dan af van de optelsom van de losse rijen, het zoeken gaat de verkeerde kant op, en de oorzaak zit niet in de measure.
Open de modelweergave en controleer of de feittabel duidelijk in het midden staat met dimensies eromheen, of dat het meer op een platte structuur lijkt. Als het op het tweede lijkt, is het model de plek om te beginnen.
Heb ik een echte datumtabel?
Alle time intelligence in DAX, van SAMEPERIODLASTYEAR tot TOTALYTD en DATESYTD, werkt met een aparte tabel die een doorlopende reeks datums bevat en expliciet gemarkeerd is via “Mark as date table”. Microsoft heeft dit als vereiste ingebouwd in hoe die functies zijn ontworpen: zonder de gemarkeerde tabel komen de uitkomsten niet overeen met wat je verwacht.
Wat ik zie: de datumkolom uit de feittabel wordt als slicer gebruikt. Dat levert een lijst met alleen de datums die in de data voorkomen, geen doorlopende reeks. Vergelijkingen met vorig jaar blijven dan leeg of geven uitkomsten die alle kanten op schieten, en het uur dat je in de measure gestoken hebt, lost het niet op.
Controleer of er een aparte datumtabel is, of die expliciet gemarkeerd is als datumtabel, en of alle datum-gerelateerde slicers op die tabel landen in plaats van op een datumkolom in de feittabel.
Welke kant op reizen mijn filters?
Power BI gebruikt one-to-many als standaard om een reden: filters lopen voorspelbaar één kant op en de filtercontext blijft eenduidig. Elke measure die op een feittabel werkt, krijgt precies de context die je verwacht.
Bidirectioneel filteren lijkt soms de makkelijke oplossing als een slicer niet het gewenste resultaat geeft. In werkelijkheid maakt het de filtercontext dubbelzinnig: een filter op één dimensie kan dan doorsijpelen naar andere feittabellen of dimensies, performance zakt zichtbaar in, en het werkelijke probleem, een ontbrekende brugtabel voor een many-to-many of een verkeerde join, blijft staan. Als bidirectioneel filteren nodig lijkt, is het bijna altijd een signaal dat het model een stap eerder al niet klopte.
Kijk per relatie in de modelweergave naar de filterrichting: staat er ergens bidirectioneel filteren aan dat je niet bewust hebt aangezet, en welke measure profiteert er waarschijnlijk het meest van zodra je die relatie rechtzet?
Dan pas CALCULATE
Als de drie diagnose-vragen groen zijn, is CALCULATE ineens gereedschap: filters toevoegen, weghalen of vervangen, en je krijgt de uitkomst die je verwacht. Je weet welke filters er zijn, je weet welke kant ze op gaan, en je weet dat de datumtabel klopt voor time intelligence.
De filterfuncties die daarna komen, FILTER, ALL, REMOVEFILTERS, ALLEXCEPT, ALLSELECTED, bouwen op hetzelfde fundament. Zie deze drie diagnose-vragen als de checklist die je vóór die reeks meeneemt, zodat je de syntax leert op een model dat al klopt.
Meer materiaal en de complete DAX-serie vind je op trainerbjorn.nl.